觀察指標
第 i 人的反應向量為 yi = (yi1, …, yiJ)。二元題 yij ∈ {0, 1}。本教材以 1 表示有該反應。
從觀察反應探究潛在異質性,辨識整體之中具有不同反應型態的群體。
LCA 從解釋類別作答的潛在結構模型,發展到能估計跨時點轉移、評估分類誤差與分析外部變數的方法。
Lazarsfeld 提出用未觀察到的類別解釋作答組合。Green 與 Anderson 推進模型形式與參數求解,Lazarsfeld 與 Henry 在 1968 年把這些研究整理成專書。 Lazarsfeld 與 Henry(1968)
Goodman(1974)發展以最大概似探索潛在結構的做法,也討論模型識別問題。Dempster、Laird 與 Rubin(1977)提出通用的 EM 演算法,使含有未觀察類別的模型可以反覆估計類別歸屬機率和模型參數。 EM 演算法原文
LCA 逐漸納入更一般的混合模型架構。潛在轉移分析(LTA)把問題從某一時點的類別歸屬,延伸到同一人在不同時點轉入哪一類。 Collins 與 Lanza 的 LTA 專章
Bolck、Croon 與 Hagenaars(2004)提出以分類誤差校正外部關聯估計的做法。Nylund、Asparouhov 與 Muthén(2007)以模擬比較 BIC、BLRT 等選模方法,Vermunt(2010)則改良帶共變項的三步驟估計。 類別數評鑑研究
三步驟法與 BCH 校正逐漸進入軟體工作流程。研究者可先依指標建立類別,再分析共變項或遠端結果,同時把硬分派的誤差納入估計。 Asparouhov 與 Muthén(2014)
gsem 則可指定潛在類別。臨床、傳播與社會調查等應用也更重視交代指標編碼、類別數判斷、類別剖面和分類品質。 StepMix 論文
潛在類別分析(LCA)用一個未觀察到的類別變數 C 解釋多個類別指標的聯合分配。以下先建立二元指標模型,再由反應型態推算類別成員機率。
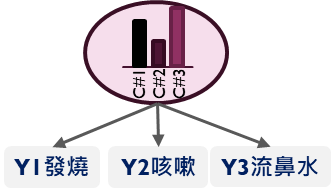
局部獨立假設給定類別 C 後,各指標的聯合機率可拆成題目機率的乘積。若忽略 C,指標仍可因類別組成不同而相關。
Oi 是第 i 人有作答的題目集合。在可忽略缺失機制的觀察資料概似中,未觀察的題目從乘積略過。若題目有多個反應類別,將每題因子換成 θjkr = P(Yj = r | C = k),同一題同一類的各反應機率加總為 1。
當 K = 1 時,各指標彼此獨立,構成比較類別數的基準模型。增加類別後若兩題仍有明顯的細格殘差,可回頭檢查它們是否因題目內容或測量方式而存在局部相依。
第 i 人的反應向量為 yi = (yi1, …, yiJ)。二元題 yij ∈ {0, 1}。本教材以 1 表示有該反應。
πk = P(C = k),k = 1, …, K。πk ≥ 0,且 Σk πk = 1。模型估計 K − 1 個獨立的類別比例。
θjk = P(Yj = 1 | C = k)。相對地,P(Yj = 0 | C = k) = 1 − θjk。同一類的 J 個 θ 值組成類別剖面。
每張圖顯示給定某一類後,各題回答「有」的機率。圖的縱軸是測量參數 θjk,類名旁的百分比則是結構參數 πk。例如第 2 類的三個症狀機率都高於 80%。選擇類別可同步查看折線圖與數值表。
對二元題,Mplus 採用 logit 連結時,閾值 τjk 決定第 k 類在第 j 題的兩種作答機率:
以第 K 類為參照時,類別截距 αk 可轉換成類別比例:
也可直接讀 Results in Probability Scale 的 Category 2 與 Based on the Estimated Model 的類別比例。
最大概似估計(ML)找出最能解釋觀察反應型態的參數。EM 與 Newton–Raphson(NR)是取得 ML 解的演算法。NR 利用梯度與曲率更新參數,接近最優解時通常更快,但曲率矩陣近奇異時可能不穩定。MLR 在最大概似架構下使用穩健標準誤,並在適用時提供校正的檢定統計量。
若第 i 列為一種反應型態,wi 是出現次數。逐筆資料則令 wi = 1。最大化的觀察資料對數概似為
E 步使用目前的 π 與 θ 計算 τik。M 步用 τik 當作分配至第 k 類的權重,更新兩組參數:
交替更新至對數概似的變化足夠小。使用多組隨機起始值,比對最佳概似能否重現,並檢查接近 0 或 1 的反應機率與極小類別。不同起始值也可能交換類別編號,比較軟體結果時可依類別剖面配對。
LCA 會為每個人估計一組類別歸屬機率。分派是決定如何把這組機率記錄成個人的分類結果。
保留每一類的機率。若一位病患對第 1、2、3 類的機率分別為 0.002、0.962、0.036,就以這三個數值記錄他對各類的歸屬。
彙整時,把每個人在某一類的權重加起來,就是該類的期望人數。
只保留機率最高的類別。這位病患的第 2 類機率最高,因此將他記為第 2 類,也就是他的最可能類別(MLC)。
彙整時,每人只計入一組。若最高機率並列,需先訂定並說明處理規則。
以發燒、咳嗽、流鼻水皆回答「有」的病患為例。πk 是看到作答前的類別比例,Lik 是第 k 類出現這種作答的機率。將兩者相乘,再除以所有類別乘積的總和。
三類機率加起來等於 1。可到 病患範例,把三個症狀都設為「有」,重做這個計算。
同一份病患資料中,軟分派用機率加總,硬分派用人數計數,因此兩種方法會得出不同的比例。
| 分派 | 第 1 類 | 第 2 類 | 第 3 類 |
|---|---|---|---|
| 軟分派 | 16.5% | 53.5% | 30.0% |
| 硬分派 | 8.1% | 56.2% | 35.7% |
硬分派給每人一個標籤,個人仍可能屬於其他類別。下一節用 D 矩陣量化這種分類誤差。
令 C 為模型中的潛在類別,G 為依最大後驗機率得到的觀察分組。D 矩陣的列是 C,欄是 G。每列的分母是該潛在類別的期望人數。
| 潛在類別 | 分派 G = 1 | 分派 G = 2 | 分派 G = 3 |
|---|---|---|---|
| C = 1 | 0.348 | 0.230 | 0.422 |
| C = 2 | 0.029 | 0.918 | 0.053 |
| C = 3 | 0.027 | 0.110 | 0.863 |
對角線表示分類正確機率。例如模型中的第 1 類有 34.8% 會被硬分派到第 1 組,另有 42.2% 被分到第 3 組。各列加總為 1。這些機率由模型的後驗機率估計。
平均後驗分派機率(APPA)反過來以硬分派組 G 為條件,估計 P(C = k | G = g)。其分母為該硬分派組的人數。Mplus 報表中的兩張表應依列、欄標題分別判讀。輔助變數分析會用到 D 矩陣的分類誤差資訊。
K 是潛在類別數,J 是二元題數。以局部獨立、各類各題的作答機率可自由估計的模型為例,先數模型要估多少參數,再數反應表能提供多少獨立資訊。
每題可答 0 或 1,J 題共有 2J 種完整作答組合。這些組合的機率總和等於 1,知道其中 2J − 1 種機率後,最後一種就能算出來。
11 大於 7,因此不同的參數組合可以產生相同的反應型態機率。即使程式收斂,資料也無法唯一決定這個無限制三類模型的參數。若自由參數數目小於或等於 7,則通過這個計數檢查,還需要檢查模型本身是否可識別。
| 評估策略 | 指標或檢定 | 判讀重點 |
|---|---|---|
| 絕對適配 | LL、−2LL、G²、Pearson χ²、LRT | 單一模型與觀察反應表的差距 |
| 相對適配 | ΔG²、LMR-LRT、BLRT、LIP | 增加類別後的適配改善 |
| 訊息準則 | AIC、BIC、saBIC、CAIC、AWE | 兼顧適配與模型複雜度 |
| 解釋力評估 | LIP、BF、cmP | 改善幅度與模型相對證據 |
| 分類診斷 | Entropy、NEC、APPA、OCC、mcaP、CLC、ICL | 分類清晰度與分派品質 |
LL 是估計解的對數概似。G² 與 Pearson χ² 則比較觀察細格次數 nr 和模型期望次數 mr。
G² 是待評估模型與飽和模型的 −2LL 差,可用於概似比檢定(LRT)。使用卡方近似前,先檢查模型自由度和細格是否稀疏。
在相同資料、指標編碼與概似定義下,比較 K 類與 K − 1 類模型。
新增類別時,混合權重可落在邊界,因此 ΔG² 的普通卡方近似通常不適用。LMR-LRT 用調整後的近似分配,BLRT 以較少類別的模型模擬資料,建立概似差的參考分配。要描述改善幅度,可看下方的 LIP。
各準則以 −2ℓ 衡量適配,再依自由參數數目 q 加上不同懲罰。用同一批資料比較時取較小值。N 是有效樣本數。
AWE 也是考慮模型複雜度的準則。TCS 調查範例可逐一加入模型,觀察 AIC、BIC 與 saBIC 分別指向 6、3、5 類。類別數選擇的模擬研究
以 M0 為基準、M1 為待評估模型。概似增量比例(LIP)以基準模型的 −2LL 為分母,表示 −2LL 降低的幅度。
可用 BIC 差近似支持 M1 相對於 M0 的貝氏因子(BF)。cmP 則在指定的一組候選模型內,將 BIC 對應的相對權重正規化。
亂度 E(K) 加總個人的後驗機率不確定性。標準化 Entropy 越接近 1,後驗機率越集中。式中 N 是權重總和,0 log(0) 以 0 計。
NEC 將亂度與概似改善一起評估。APPA 是硬分派組內的平均後驗機率,OCC 比較後驗分類勝算與依類別比例得到的基準勝算,mcaP 是硬分派後的組別比例。CLC 和 ICL 則在模型評估中納入分類不確定性。
可搭配 D 矩陣、最小類別比例、最佳概似能否重現,以及各類剖面是否有實質意義一起判讀。
先釐清外部變數扮演的角色。共變項 X 用來解釋誰較可能屬於某個潛在類別。遠端結果 Z 用來比較各類在外部結果上的平均數或事件機率。
例如以年齡預測 TCS 使用類別。以第 K 類為參照,對第 k 類估計 log[P(C = k | X)/P(C = K | X)] = αk + βkX。exp(βk) 是 X 增加一單位時,歸入第 k 類相對於參照類的勝算比。
例如比較各 TCS 類別的生活滿意度平均數 E(Z | C = k),或比較二元結果的事件機率 P(Z = 1 | C = k)。在觀察資料中,類別間的差異描述模型下的關聯。
| 策略 | 操作與適用情境 |
|---|---|
| 單階段 | 共同估計測量模型和外部關聯。外部變數可影響類別比例及測量參數估計,因此要比較加入前後的類別剖面。 |
| 虛擬分類 | 依個人的後驗機率重複抽取類別,分別估計後彙整。能表達分派變異,但直接從只含指標的後驗機率抽取時,外部關聯仍可能偏誤。 |
| 二階段 | 先估計指標測量模型,再固定測量參數並估計含外部變數的結構模型。推論需考慮第一階段的估計不確定性。 |
| 校正三階段 ML | 先估計測量模型,再以最可能類別 G 和 D 矩陣建立分派模型,最後固定分派誤差估計外部關聯。Mplus 的 R3STEP 用於共變項,DU3STEP 用於允許類別間變異數不同的連續遠端結果。 |
| BCH | 透過 D 矩陣的反矩陣建立分類誤差校正權重,常用於比較連續遠端結果。分類分離度低時,權重可能不穩定或為負,應檢查變異數和標準誤。 |
| LTB | 以潛在轉移架構表達測量部分和輔助部分,利用限制連結兩階段的類別變數。適合用來理解階段間的類別對應與測量限制。 |
以共變項分析為例,三階段 ML 把 G 視為 C 的不完美指標。給定 X,分派到第 g 組的機率是各潛在類別的機率乘上相應分派機率後加總。
若直接把硬分派 G 當作觀察到的真實類別,估計的類別差異會混入分類誤差。使用三階段方法時,先檢查 D 矩陣是否顯示某些類別經常互相誤分。
以下各行分別示範一種分析。x 與 z 要先出現在資料變數清單中,並依實際研究問題選用一種設定。
! 共變項預測類別
AUXILIARY = x (R3STEP);

! 比較連續遠端結果的類別平均數
AUXILIARY = z (BCH);
報告時說明類別數如何決定、測量模型是否固定、分類誤差如何校正,以及所報告的勝算比、平均數差異或事件機率。複雜遠端模型可用手動 BCH 指定共變項及類別間限制。Mplus 輔助變數技術說明
類別指標用潛在類別分析(LCA),連續指標用潛在剖面分析(LPA),跨時點的類別轉移用潛在轉移分析(LTA)。若要用共變數預測類別,或比較各類的外部結果,可再比較工具是否能在分步估計時校正分類誤差。
| 工具 | 主要開發者 | 年代/版本 | 模型與操作 | 適用情境 | 限制與注意事項 |
|---|---|---|---|---|---|
| Mplus | Linda K. Muthén、Bengt O. Muthén | 1998 首版/9.1.1 | LCA、LPA、LTA;語法 | 可結合混合 SEM 與多層次模型;依模型使用 LMR、BLRT、BCH。 | 商業授權;先確認所用估計法與模型支援哪些檢定。 |
| LatentGOLD | Jeroen K. Vermunt、Jay Magidson | 2000 公開版/6.1 | LCA、LPA、LTA;GUI 與語法 | 可用圖形介面探索類別剖面,並以 Step3 分析外部變項。 | 依作業系統、用途及所需模組確認授權。 |
| R · poLCA | Drew A. Linzer、Jeffrey B. Lewis | 2006 CRAN/1.6.0.2 | 類別指標 LCA;R | 適合練習基本 LCA 與類別成員迴歸,可用多組起始值。 | 連續指標的 LPA 與跨時點 LTA 需另選工具。 |
| R · LCPA | Haijiang Qin、Lei Guo | 2026 CRAN/1.0.4 | LCA、LPA、LTA;R | 可比較不同估計方法,並可串接 Mplus。 | 可用功能依後端而異。使用 Mplus 後端須另裝 Mplus。 |
| R · tidySEM | Caspar J. van Lissa、Mauricio Garnier-Villarreal 等 | 2020 CRAN/0.2.12 | LCA、LPA、成長混合;R | 可用 lavaan 式語法整理模型、類別剖面與報告。 | 混合模型工作流程使用 OpenMx;檢查所選模型與估計法。 |
| Python · StepMix | Sacha Morin、Zsuzsa Bakk 等 | 2023 首版/2.2.x | LCA、LPA;Python、R 介面 | 可用一步、兩步及三步估計,支援 BCH 與 ML 分類誤差校正。 | 適合外部變項分析與程式化重現;LTA 需另選工具。 |
| Stata · gsem | StataCorp | 2017 Stata 15/Stata 19 | LCA、LPA;lclass() 語法 | 適合在同一模型內處理混合型指標、共變數與群組。 | 商業授權;若收斂不穩,需比較起始值和重複解。 |
| jamovi · snowRMM/snowLatent | Hyunsoo Seol | snowRMM 6.x | LCA、LPA;點選式介面 | 適合課堂快速比較類別剖面。 | 各模組可用的模型和檢定依版本而異。 |
| SAS · PROC LCA/PROC LTA | Stephanie T. Lanza、Linda M. Collins 等 | 2007 首版/1.3.2(2015) | LCA、LTA;SAS 外掛 | 可納入共變數,並依程序處理多組、抽樣權數與叢集。 | 須確認 Windows、SAS 版本與外掛安裝條件。 |
| IBM SPSS Statistics | Norman H. Nie 等;IBM | 1968 首版/32.0 | LCA 擴充指令;SPSS | 既有 SPSS 流程可使用 STATS LATENT CLASS 擴充。 | 安裝前核對擴充指令與 R 整合環境的相容性。 |
| JASP | Eric-Jan Wagenmakers、Jonathon Love 等 | 2013 開始開發/0.98.1 | 圖形介面;依模組確認 | 可作為一般統計教學介面。 | 依官方模組清單確認所需的 LCA、LPA 或 LTA 功能。 |
跨軟體比較時,先對齊指標編碼、遺漏值處理和模型限制。類別編號可能交換,可依條件反應機率對齊類別,再比較類別比例與模型適配度。
Taiwan Communication Survey 自 2012 年起透過面訪等方式,長期記錄臺灣民眾如何使用媒體,以及媒體與人際互動、娛樂和公共生活的關係。TCS 官方網站
本例使用張卿卿(2025)釋出的第三期第三次(2024)面訪公共版《傳播與生活日常:消費、健康與娛樂》(D00265_1)。調查於 2024 年 6 月 24 日至 9 月 26 日完成 2,016 案,對象為臺灣本島年滿 18 歲、具有本國國籍的民眾。SRDA 資料與問卷 · 資料 DOI
E13 是「上網的原因或動機」複選題。模型取前六個選項,各自編成一個二元指標。五類模型用這六題的作答組合描繪不同的上網型態。
| 指標 | 上網動機 | 勾選人數 | 勾選率 |
|---|---|---|---|
Y1 ve13m01 | 維繫友誼 | 1,566 | 84.3% |
Y2 ve13m02 | 娛樂消遣 | 1,395 | 75.1% |
Y3 ve13m03 | 時事、新聞或政府資訊 | 1,248 | 67.2% |
Y4 ve13m04 | 生活休閒資訊 | 1,149 | 61.9% |
Y5 ve13m05 | 理財、消費與購物 | 822 | 44.3% |
Y6 ve13m06 | 工作或學習 | 933 | 50.2% |
每題的勾選率都以 1,857 人為分母。每人可勾選多項,所以各題勾選率可以合計超過 100%。
ve13m01 到 ve13m06,依序對應 Y1 到 Y6。「其他」與 E14 的網路消費金額未用於這個六指標模型。FREQWEIGHT 在此表示作答型態的人數。重做本例可用已編碼的課堂 CSV 與 資料整理程式。「語法與結果」的 TCS 模擬練習使用合成資料,可公開下載並重跑。這裡的樣本摘要和五類剖面來自正式課堂案例。
切換觀察值,看看哪些題目改變最可能類別。未觀察的題目會略過。
讀取各類的 P(Yj = 1 | C = k),並比較指標之間的高低。圖中的 Y1、Y2 等依序對應表中的指標欄。作答為 1 對應 Mplus 機率表的 Category 2。
在上方選擇案例與類別數。每套軟體左側顯示語法,右側顯示使用相同資料與類別數的估計報表。R 使用 base R,Python 使用標準函式庫。
比較報表時,先核對 LL 和資訊準則,再依各類的條件機率對齊類別。R 與 Python 依類別比例排列,Mplus 沿用原生編號。類別編號與起始值可能不同,病患三類以上的模型也可能出現相同概似下的不同參數解。
用這 12 問檢查自己的研究設計、估計與報告。勾選已查核的項目。各題的狀態標籤是課堂投影片對 TCS 案例的評估。
方法意義 釐清要探索或驗證哪種潛在異質性,並保留外部結果供後續驗證。
TCS 範例 部分具備 以六種上網動機辨識類型。宜明示探索定位,補充分群後要回答的研究問題。
方法意義 區分類型差異與程度差異。潛在類別是異質性的模型描述,應以實務證據支持。
TCS 範例 部分具備 動機組合有實務意義。可比較 C1、C2 的程度與形狀,避免將類別實體化。
方法意義 以理論支持指標選擇、預期類型與類別差異,區分事前預期與事後解釋。
TCS 範例 待補強 連結網路使用動機理論,說明事前預期,區分剖面探索與事後命名。
方法意義 檢查指標的概念涵蓋、區辨力、反應尺度、編碼與內容重複。
TCS 範例 部分具備 題目由調查團隊設計。宜補充概念與測量依據,檢查六題的反應分布與區辨力。
方法意義 分別評估代表性與估計精確度,交代抽樣、權重及最小類別的估計需求。
TCS 範例 已具備 投影片記載全國四階段 PPS,有效樣本 1,857 筆,調查資料有權重。分析報告仍須交代實際使用的權重。
方法意義 記錄清理與特殊碼轉換,報告遺漏比例、處理方式和最終納入樣本數。
TCS 範例 部分具備 清理已程式化。重做輔助分析時,應核對年齡特殊碼及異常標準差,並交代遺漏、加權與樣本處理。
方法意義 報告估計法與起始值,檢查最佳 LL 能否重現、收斂警告及異常參數。
TCS 範例 部分具備 投影片指出五類 LL 跨軟體相近,tidySEM 的差異較大。宜補報最佳 LL 重現次數,並檢查四類解與 BLRT。
方法意義 檢查局部獨立、指標分布及固定或跨類限制,必要時比較替代模型。
TCS 範例 待補強 投影片列出 G² = 43.47、p = .041。宜查稀疏細格與二變項殘差,並交代參數限制與替代模型。
方法意義 事先訂定選模準則、最大類別數與停止或排除規則,區分計畫分析與探索。
TCS 範例 部分具備 已比較 1–6 類。宜補充最多六類的依據、停止規則與準則不一致時的取捨。
方法意義 呈現適配度、類別比例與分類品質,區分模型估計與硬分派比例,報告不確定性。
TCS 範例 部分具備 已有選模、剖面與分類品質表。宜確認各類 AvePP 與誤差矩陣,並補報標準誤或信賴區間及警告。
方法意義 保留語法、版本與隨機種子。用敏感度分析比較合理的替代設定,檢查主要結論是否改變。另用可比較的獨立樣本驗證類別剖面及外部關聯,並校正分類誤差。
TCS 範例 待補強 可比較三至五類解、不同遺漏值處理,以及採用與未採用調查權重的結果。依條件反應機率對照各類,檢查類別比例、剖面與主要結論是否改變。獨立樣本驗證仍待完成。
方法意義 依完整剖面命名,把類名當作摘要,避免過度宣稱固定本質、因果或最佳解。
TCS 範例 待補強 檢查 C5 是否主要由娛樂題界定,對照三類與四類解,交代替代解釋與限制。
將程式與資料放在同一資料夾,依下載區的說明執行。用同一組指標與類別數比較結果,對照時先依剖面配對類別編號。
使用對應的反應型態資料檔,執行三類病患或五類 TCS 模擬練習。
以 base R 執行多起始值的 EM,輸出對數概似、資訊準則與各類條件反應機率。
以 Python 標準函式庫執行相同的二元 LCA,輸出類別比例與反應機率。